如何在 Mac 上离线搜索视频字幕与转录
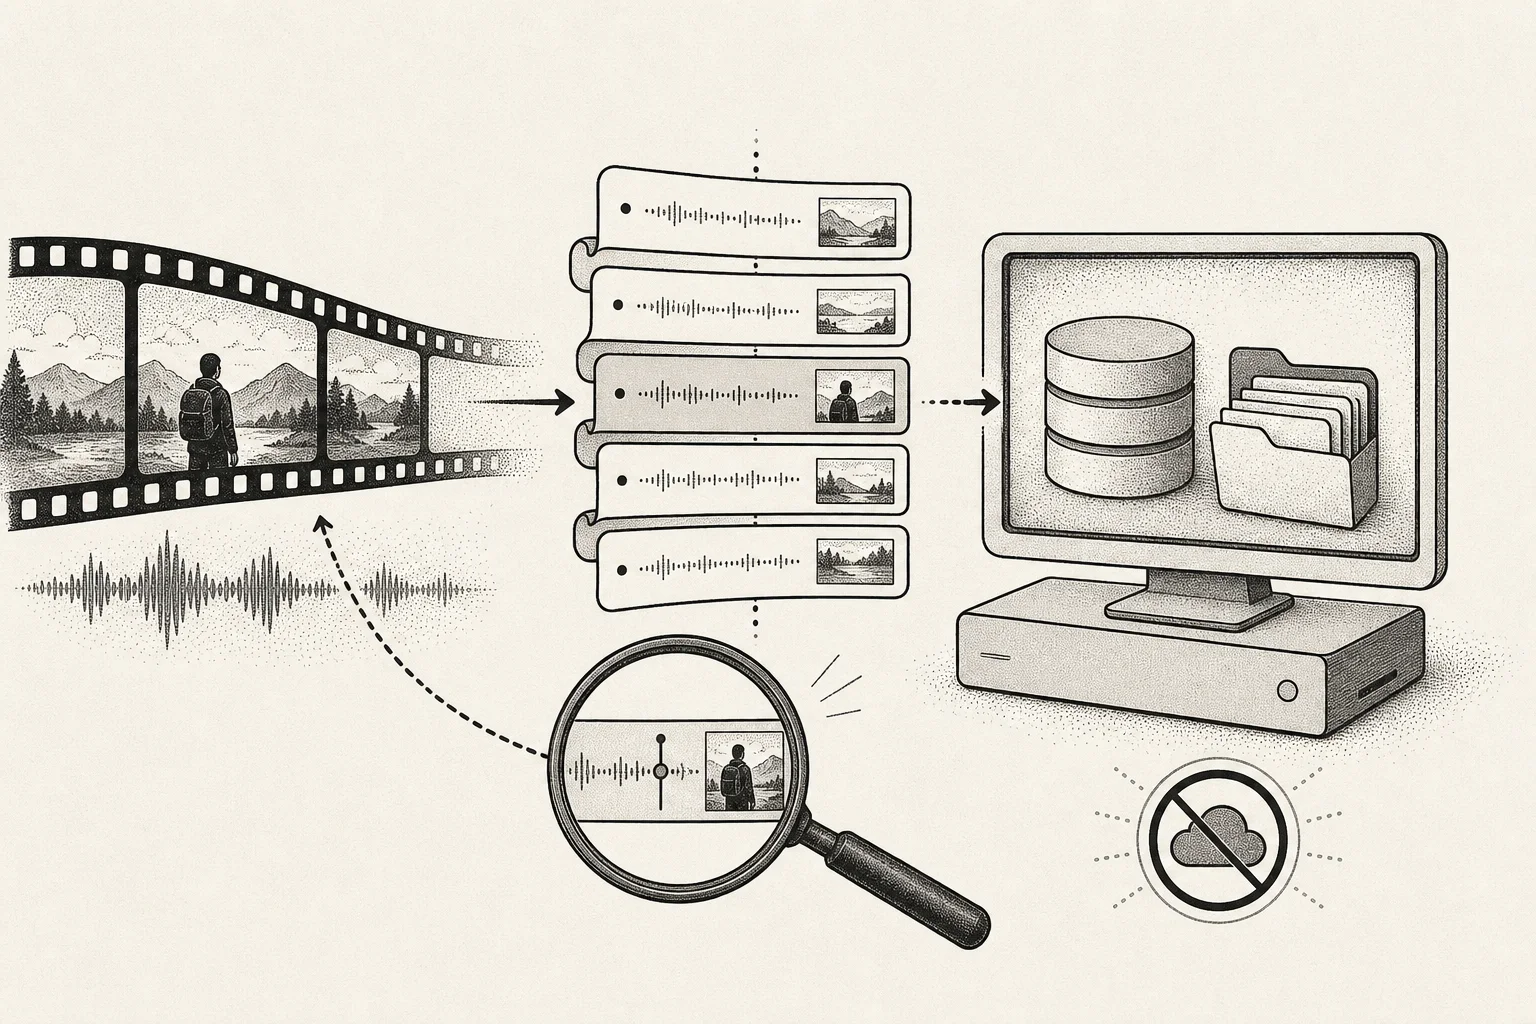
要离线搜索视频内容,需要先把语音转换成带时间戳的字幕,再搜索字幕文本。真正有用的结果不只是“这段话出现过”,还应该保存开始和结束时间,让你点击命中后直接回到视频里的那一刻。
先确认字幕是否真的存在
打开视频的字幕列表,先看有没有能读到的字幕条目。下面是专门测试视频的真实空状态:播放器能播放,并不表示字幕已经生成或可供搜索。
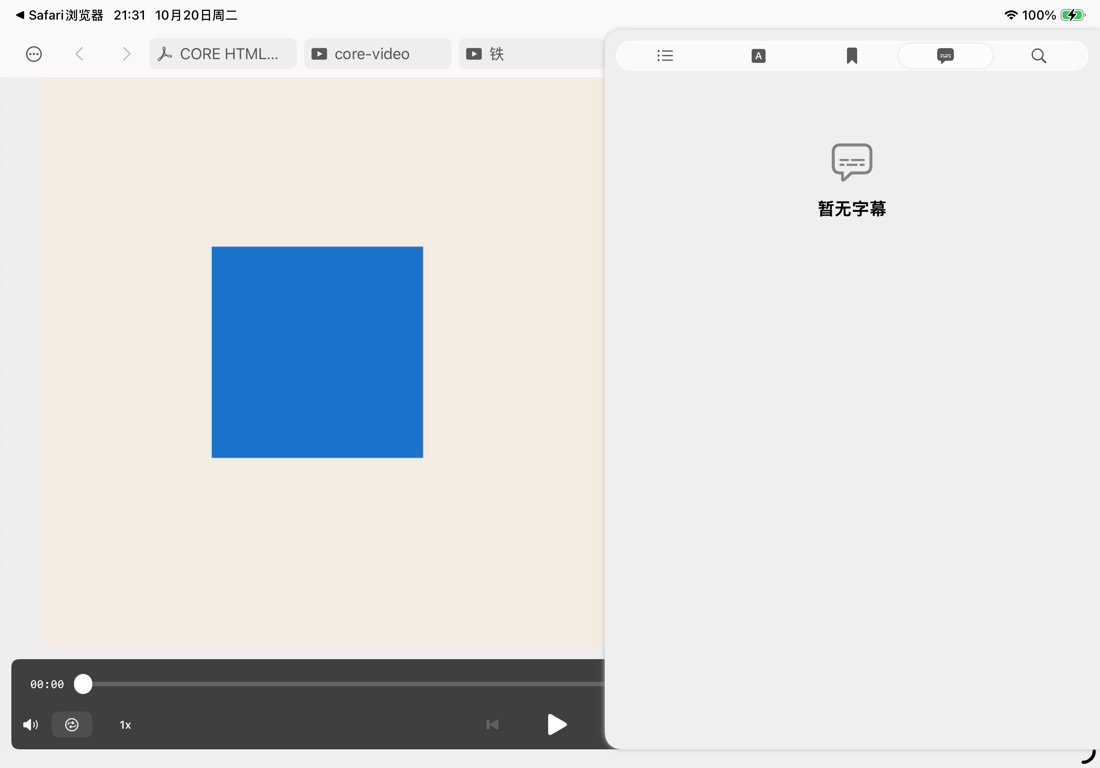
有字幕后,选一个你能在列表中看到的词测试文档内搜索,再打开命中结果核对时间和原声。最后测试资料库搜索。转录任务结束但列表仍为空时,应先排查转录结果,不能把它当成索引已经就绪。
视频搜索其实是三个连续步骤
- **转录:**从音轨识别人说的话。
- **定位:**给每条字幕保存开始和结束时间。
- **索引:**把字幕文字加入全文搜索,并让结果保留时间戳。
只生成一份没有时间信息的 TXT 文件,虽然能查词,却很难回到原视频核对。只有时间戳、没有跨视频索引,又会迫使你逐个打开视频搜索。一个完整流程需要同时解决这三件事。
OpenAI Whisper 是通用语音识别模型,支持多语言语音识别、语言识别和语音翻译等任务。像 DoCube 这样的本地应用可以在模型下载完成后,在 Mac 上直接运行识别,而不把音频上传到转录网站。
哪种方法适合你
| 需求 | 做法 | 限制 |
|---|---|---|
| 视频已经有字幕 | 直接导入并搜索现有字幕 | 字幕质量由来源决定 |
| 偶尔处理一段视频 | 本地转录后导出 SRT/VTT | 仍要自己管理字幕文件 |
| 长期搜索课程、会议或访谈 | 把视频、字幕索引和播放器放在同一资料库 | 首次转录和索引需要时间 |
| 还想搜索画面文字或物体 | 额外做关键帧 OCR 或视觉索引 | Whisper 只理解音轨,不分析画面 |
最后一条很容易混淆:字幕搜索只能找到说出来的话。幻灯片上的文字、代码画面和没有念出的标题,不会因为生成了 Whisper 字幕就自动可搜索。
在 DoCube 中本地生成并搜索视频字幕
1. 准备本地字幕模型
打开“设置 → AI 助手”,在“本地模型”区域下载并选择视频字幕使用的 Whisper 模型。下载模型需要网络;文件准备完成后,字幕生成本身可以离线运行。
模型越大,通常越需要内存和处理时间。长视频开始前,应为模型、临时音频和字幕数据预留足够存储,并关闭暂时不用的大型应用。
2. 导入视频并生成字幕
如果是第一次操作,可以先按Mac 上用 Whisper 生成视频字幕的图文教程完成模型下载、导入和字幕校对,再回来搜索。
把本地视频导入 DoCube,打开视频文档:
- 如果文件已有可用内嵌字幕,可以直接使用。
- 没有字幕时,点击“生成字幕”开始本地识别。
- 已开始但未完成的任务可以继续处理。
- 识别期间保持应用和当前文档打开,并观察进度。
字幕完成后,字幕列表会跟随播放位置高亮当前条目。选择任意一条,就会跳到它的开始时间。
3. 搜索当前视频
打开“文档内搜索”,输入词语或短语。搜索范围是当前字幕,不会重新分析音频或画面。结果会显示命中字幕及前后文;选择结果即可跳到对应时间。
需要找姓名、术语和原句时,文档内搜索最快。字幕没有生成完成,或者识别文本里写错了目标词,结果就不会出现。
4. 搜索整个视频资料库
视频字幕也会进入 DoCube 的全库索引。点击标签栏中的“在 DoCube 中搜索”,就可以同时检索多段视频,以及 PDF、EPUB、网页、Markdown 和自己的标注。
全库结果会保留字幕时间位置。打开结果时,播放器跳回对应时间,而不是只打开视频开头。
5. 把重要片段变成可找回的知识
选择字幕文字后,可以创建高亮、引用、Markdown 标注、链接或卡片。标注会同时保存所选文字和时间范围;以后从搜索或标注列表打开时,仍能返回对应画面。
如果需要把一个片段放进另一篇笔记,可以复制该视频位置的 DoCube 地址。这个地址不仅指向视频文件,还能记录播放时间。
离线转录真正保护了什么
本地 Whisper 的核心价值是音频不需要上传到第三方转录网站。适合会议记录、访谈、课程录像和未公开素材。
但后续功能可能有不同的数据边界:
- 本地生成字幕、搜索字幕:模型下载完成后可以离线进行。
- 翻译字幕:使用你配置的在线模型时,相关字幕会发送给服务商。
- AI 自动生成视频章节:同样依赖所配置的在线服务。
不要因为“字幕是本地生成的”,就默认之后的翻译和总结也在本地完成。
提高转录和搜索命中率
- 优先使用清晰、近讲者的音轨,减少背景音乐和混响。
- 选择与设备内存和视频长度匹配的模型。
- 人名、缩写和专业术语完成后要抽查并手动修正。
- 搜不到时尝试词干、同音变体或更短的片段。
- 多语言视频先确认识别出的原文语言是否正确。
- 重要结论始终回到音频与画面核对,不只看转录文字。
什么时候字幕搜索不够
以下需求需要额外的视觉处理:
- 找某张幻灯片出现的文字,但讲者没有念出来。
- 找某个产品、人物、场景或动作。
- 搜索无声屏幕录制中的菜单和代码。
- 按镜头相似度或画面内容查找片段。
这时应加入关键帧抽取、OCR、画面描述或视觉向量索引。它们与语音转录是互补关系,不是 Whisper 的同一项能力。
常见问题
第一次使用时能完全断网吗?
不能。需要先联网下载本地 Whisper 模型。模型完整下载后,DoCube 的字幕生成和字幕搜索可以离线完成。
搜索结果能直接跳回视频时间吗?
可以。文档内字幕结果和全库视频字幕结果都会保留时间位置;字幕标注也保存对应时间范围。
Whisper 会搜索视频画面里的文字吗?
不会。Whisper 处理音轨。画面文字需要 OCR 或视觉索引;没有说出口的内容不会出现在字幕搜索中。
自动字幕可以直接当作正式记录吗?
不建议。人名、数字、否定词和专业术语最需要核对。正式会议纪要、采访引用或法律材料应回听原音并人工校订。
如果你还想把视频片段链接进阅读笔记,可以继续阅读如何把笔记链接回 PDF 和 EPUB 的具体位置。