如何在 Mac 上搜索数百个 PDF,包括扫描件
如果要在几百份 PDF 里找一句话,正确做法不是逐个打开文件按 Command-F,而是先确认每份 PDF 是否有可搜索的文本层,再建立覆盖整个资料库的全文索引。扫描 PDF 只有页面图像,必须先做 OCR;有文本层的 PDF 才能稳定进入跨文档搜索。
先用一段确定的原文验证搜索
先打开一份有文本层的 PDF,搜索一句你能在页面上看到的短语。确认结果能返回原页后,再用同一个词测试资料库搜索。这样能分清是文件没有可用文字,还是资料库尚未完成索引。
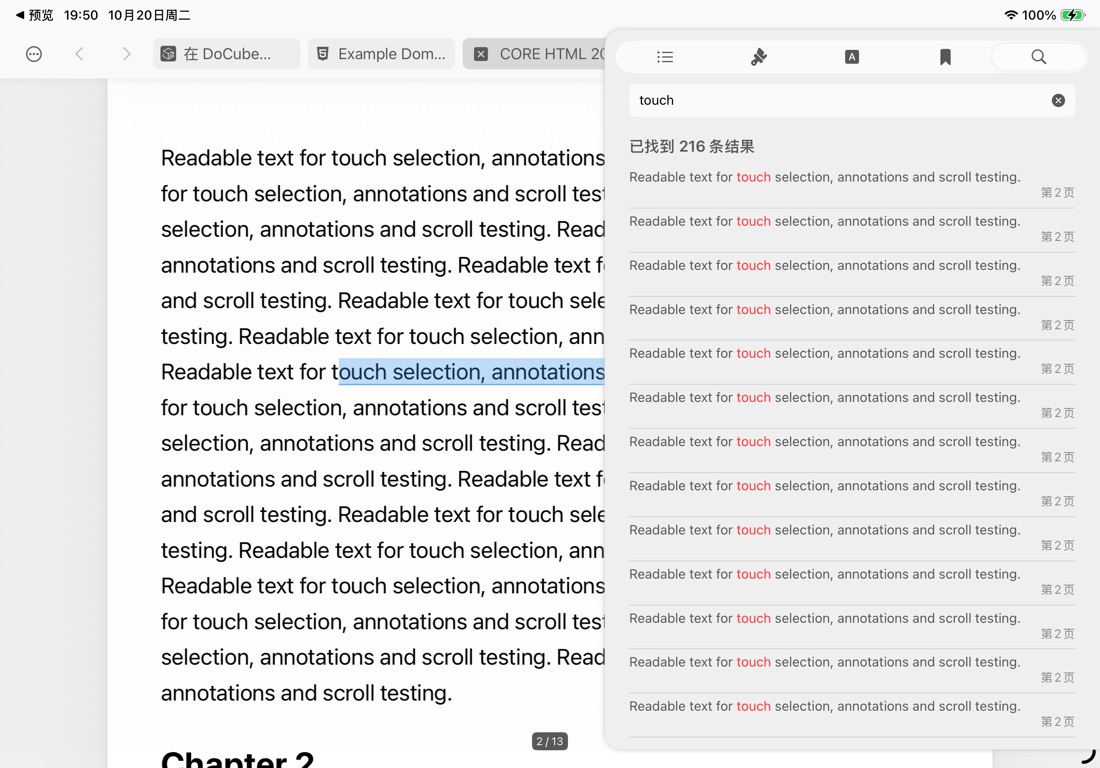
接着在资料库中搜索该词,打开一条结果,核对来源文档和命中位置。扫描件则先做 OCR,再重复这两个检查。
先做一个 10 秒检查:这份 PDF 是文字还是图片
打开一份 PDF,尝试拖动选择其中一句话:
- 能按单词和句子选择,说明文件已经有文本层,可以直接搜索。
- 只能选中整页,或者完全无法选择文字,通常说明它是扫描件。
- 能选择但复制出来是乱码,说明文本层存在,但编码或 OCR 质量有问题。
这一步很重要。搜索工具只能检索它实际读到的文字;页面看起来有字,不代表文件里真的保存了文字。
根据资料量选择搜索方式
| 你的情况 | 合适的方法 | 主要限制 |
|---|---|---|
| 只找当前打开的一份 PDF | 预览或阅读器里的 Command-F | 不能跨文件比较结果 |
| PDF 都在一个固定文件夹 | Spotlight,或 Acrobat 的多文件搜索 | 扫描件和异常文本层仍可能搜不到 |
| 长期管理数百到数千份资料 | 建立本地全文索引的文档库 | 首次导入和建索引需要时间 |
| 不记得原文措辞,只记得意思 | 关键词搜索加本地语义索引 | 需要额外模型、存储和计算资源 |
macOS 的 Spotlight 使用保存在设备上的索引查找文件和内容,适合先做一次低成本尝试;索引仍在建立时,结果可能暂时不完整。可以参考 Apple 对 Spotlight 索引的说明。
如果 PDF 都在一个目录里,Adobe Acrobat 的高级搜索可以把范围设为某个文件夹,而不是当前文档。Adobe 的多 PDF 搜索说明也建议对大型、稳定的资料集建立目录索引。
当你还想同时搜索 EPUB、网页、Markdown、视频字幕和自己的标注时,单纯的文件夹搜索就不够了。此时更适合把资料导入一个本地文档库,由同一份索引管理正文和阅读痕迹。
扫描 PDF 为什么必须先做 OCR
扫描 PDF 的每一页本质上是一张图片。OCR 会识别图像中的字符,生成可以选择和检索的文本数据。
做 OCR 时有三点值得注意:
- 先选对主要语言;中英混排时再加入次要语言。
- 保留原文件或备份,尤其是批量处理之前。
- 抽查姓名、数字、公式和分栏顺序,不能只看“识别完成”。
复杂分栏、公式、代码和低清扫描件最容易产生错误。OCR 能让资料进入搜索,但不能保证识别结果等同于原文。Adobe 也明确说明,OCR 是把图像文字转换为可选择、可搜索文本层的步骤,处理后仍应检查准确性。查看 Adobe 的扫描文档 OCR 指南。
用 DoCube 建立一个可搜索的本地 PDF 资料库
如果目标不是临时找一次,而是长期积累和找回资料,可以使用下面的流程:
- 在添加菜单中导入文件,或选择“目录导入”批量扫描一个文件夹。需要保留来源层级时,打开“保持目录”。
- 打开扫描 PDF,在 Mac 顶部工具栏选择“文本识别”;选择主要语言和需要的次要语言后开始 OCR。
- OCR 完成后,DoCube 会重新打开带文本层的识别版本。原始 PDF 不会被直接改写。
- 等待新导入正文完成解析和索引。资料很多时,导入、OCR 与搜索索引会分阶段完成。
- 点击标签栏中的“在 DoCube 中搜索”,输入关键词、原句片段或简短问题,按 Return。
- 在结果页按文档类型选择 PDF,也可以继续按标签、来源文档或内容来源缩小范围。
- 选择结果卡片核对上下文,再打开原文;PDF 结果会带你回到匹配页面和位置。
DoCube 的全库搜索不只覆盖 PDF 正文,也覆盖 EPUB、HTML、Markdown、MinerU、视频字幕,以及高亮、引用、链接、Markdown 标注和卡片。这样你可以用“自己写过的词”找回原文,而不必只记得作者原来的措辞。
什么时候需要语义搜索
关键词搜索适合明确的姓名、术语、编号和原句。以下情况可以考虑语义搜索:
- 记得意思,但不记得原文用了哪个词。
- 不同作者用不同术语描述同一个概念。
- 想找相近观点,而不是完全相同的字符串。
在 DoCube 中,可以先下载本地 QWen3 Embedding 模型,再为新查询开启“语义化搜索”。它会把 BM25 关键词结果与向量结果合并排序。模型下载完成后,向量索引建立和搜索可以在设备上离线完成;首次处理大型资料库会占用时间、存储和内存。
语义相近不等于事实一致。涉及数字、条件和结论时,仍应打开来源片段核对。
搜不到内容时,按这个顺序排查
- 先在当前 PDF 中搜索。 当前文件也搜不到,优先检查文本层或 OCR。
- 缩短查询。 先用连续出现的两三个关键词,不要一开始输入很长的问题。
- 等待索引。 刚导入、刚 OCR 或刚修改的内容可能还没有进入索引。
- 移除筛选。 检查是否误选了文档类型、标签、来源或大小写限制。
- 检查 PDF 权限与编码。 加密、损坏或异常字体编码会影响文本提取。
- 最后再重建索引。 不要把重建索引当作第一个动作;它不能修复缺失的文本层。
本地搜索和 AI 总结不是同一件事
关键词索引、OCR 和本地 Embedding 可以在设备上工作。搜索结果的 AI 总结则不同:启用后,查询和当前结果片段会发送给你配置的 AI 服务商。处理敏感论文、合同或内部资料时,应分清“本地找回原文”和“把结果交给在线模型总结”这两个步骤。
常见问题
Spotlight 能搜索所有扫描 PDF 吗?
不能保证。Spotlight 依赖可用的索引内容;只有页面图像、文本层异常或仍未完成索引的 PDF 可能搜不到。先完成 OCR,再抽查一个明确词语。
OCR 会改变原 PDF 的页面外观吗?
不同工具行为不同。DoCube 会生成识别版本并保留原页面外观,不直接改写导入的原始 PDF;其他批量工具应先确认输出位置和覆盖策略。
几千份 PDF 应该使用关键词还是语义搜索?
先建立稳定的关键词索引。关键词结果更容易解释,也适合姓名、数字和术语。语义搜索适合作为第二条检索路径,而不是替代关键词搜索。
如果你还在决定资料和笔记应该如何保存,可以继续阅读如何在本地管理 PDF 和 EPUB 笔记。DoCube 可在 App Store 免费下载,免费版可以先用少量文档验证整套搜索流程。